
สตรีมคำตอบจาก AI ไปยังทุกหน้าจอ
แชตบอต โคไพลอต และเอเจนต์ AI: คำตอบที่ปรากฏขณะเขียน ไปถึงทุกแท็บและอุปกรณ์ และเขียนต่อได้หลังรีโหลด
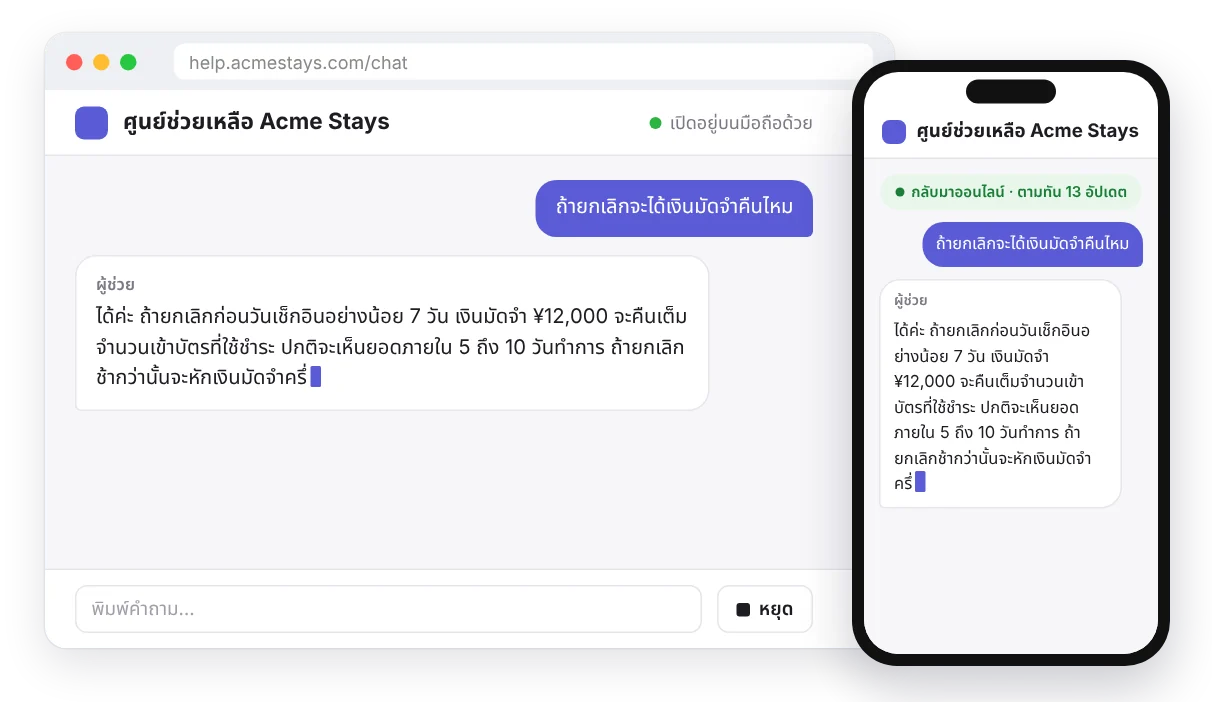
แชตบอต โคไพลอต และเอเจนต์ AI จะรู้สึกเร็วเมื่อคำตอบปรากฏขึ้นขณะที่โมเดลกำลังเขียน แอปส่วนใหญ่สตรีมคำตอบผ่าน HTTP response เส้นเดียวที่ส่งคำถามมา วิธีนี้ใช้ได้จนกว่าผู้ใช้จะรีโหลดหน้า เปิดแท็บที่สอง สลับไปใช้มือถือ หรือเพื่อนร่วมทีมอยากดูคำตอบเดียวกัน คำตอบยาว ๆ ยังอาจเกินเวลาที่ฟังก์ชัน serverless รันได้ การเผยแพร่คำตอบไปที่แชนเนลช่วยแยกงานของโมเดลออกจากการเชื่อมต่อของเบราว์เซอร์ ทุกหน้าจอที่สมัครรับข้อมูลจะเห็นข้อความเดียวกัน และหน้าจอที่หลุดไปจะตามทันจากประวัติของแชนเนล สแตกที่ใช้กันบ่อยมีแพ็กเกจโอเพนซอร์สของเราที่จัดการการรวมเป็นชุด การเรียงลำดับ และการตามให้ทัน คุณจึงเพิ่มแค่ไม่กี่บรรทัดแทนการเขียนเอง
สิ่งที่ผู้ใช้ได้รับ
- คำตอบที่ค่อย ๆ ปรากฏทีละคำ ไม่ต้องรอทั้งหมด
- คำตอบเดียวกันในทุกแท็บ ทุกอุปกรณ์ และสำหรับทุกคนในแชตที่ใช้ร่วมกัน
- คำตอบที่เขียนต่อได้หลังรีโหลดหรือหลุดการเชื่อมต่อ โดยเติมเฉพาะส่วนที่ขาดไป ไม่ต้องเริ่มใหม่
- ปุ่ม "หยุด" และคำตอบที่ยังเขียนต่อแม้ผู้ใช้ปิดแท็บไปแล้ว พอกลับมาผลลัพธ์ก็พร้อม
สร้างด้วย
- แชนเนลส่วนตัว เพื่อให้เฉพาะคนที่อยู่ในบทสนทนาอ่านคำตอบได้ โดย endpoint ยืนยันสิทธิ์ของคุณเป็นผู้ตรวจสอบ
- ประวัติของแชนเนล (
pusher:rewindแพ็กเกจ Hobby ขึ้นไป เปิดได้ในการตั้งค่าของแต่ละแอป) หน้าจอที่เชื่อมต่อใหม่จะได้รับอีเวนต์ที่พลาดไป - แพ็กเกจของเรา สำหรับ Vercel AI SDK, React, Vue, Nuxt และ Laravel ซึ่งรวม token เป็นอีเวนต์ที่เล็กกว่าขีดจำกัด 4 KB ของ Free ใส่หมายเลข แล้วเรียงกลับตามลำดับ
- โมเดลและ API key ของคุณเอง: ใช้โมเดลใดก็ได้ที่สตรีมข้อความได้ Hibira ทำหน้าที่ส่งข้อความไปถึงผู้ใช้เท่านั้น
เลือกแพ็กเกจตามสแตกของคุณ
| คุณใช้ | แพ็กเกจ | ฝั่งเบราว์เซอร์ |
|---|---|---|
Vercel AI SDK useChat | @hibira-io/ai-sdk | HibiraChatTransport |
| SDK ของ Anthropic, OpenAI หรือ Gemini กับ React หรือ Vue | @hibira-io/react, @hibira-io/vue | useStream() |
| เอเจนต์ Laravel AI SDK | hibira-io/laravel | useAgentStream() |
| ภาษาหรือเฟรมเวิร์กอื่น | ไลบรารีเซิร์ฟเวอร์ Pusher ใดก็ได้ | pusher-js |
Vercel AI SDK: transport สำหรับ useChat
useChat() ใช้ได้เหมือนเดิม แค่คำตอบมาทางแชนเนลแทน HTTP response ฝั่งเบราว์เซอร์:
import { useChat } from '@ai-sdk/react';
import { HibiraChatTransport } from '@hibira-io/ai-sdk';

const transport = new HibiraChatTransport({ pusher, api: '/api/chat' });

export function Chat({ id, initialMessages }) {
  const { messages, sendMessage, status } = useChat({ id, messages: initialMessages, transport, resume: true });
  // render messages as usual
}
API route ตอบกลับทันทีและเผยแพร่สตรีมของโมเดลในเบื้องหลัง:
import { after } from 'next/server';
import { streamText, convertToModelMessages } from 'ai';
import { publishUIMessageStream } from '@hibira-io/ai-sdk/server';

export async function POST(req: Request) {
  const { id, messages, runId } = await req.json();
  const result = streamText({ model, messages: await convertToModelMessages(messages) });
  after(() =>
    publishUIMessageStream(pusher, {
      chatId: id,
      runId,
      stream: result.toUIMessageStream({ originalMessages: messages, onFinish: ({ messages }) => saveChat(id, messages) }),
    }),
  );
  return Response.json({ runId }, { status: 202 });
}
transport จะสมัครรับ private-ai-chat-{chatId} ดังนั้นใน endpoint ยืนยันสิทธิ์ให้อนุญาตแชนเนลนี้เฉพาะเจ้าของแชต เมื่อใส่ resume: true หน้าที่รีโหลดจะรับคำตอบที่ยังเขียนอยู่ต่อได้
React หรือ Vue กับ SDK ของโมเดลใดก็ได้
streamToChannel() รับสตรีมจาก SDK ของ Anthropic, OpenAI หรือ Gemini ได้ตามที่เป็นอยู่:
import { streamToChannel } from '@hibira-io/react/server';

export async function POST(req) {
  const { conversationId, question } = await req.json();
  const stream = anthropic.messages.stream({ model, max_tokens: 1024, messages: [{ role: 'user', content: question }] });
  const id = crypto.randomUUID();
  streamToChannel(pusher, `private-conversation-${conversationId}`, stream, { id }).catch(console.error);
  return Response.json({ id });
}
import { useStream } from '@hibira-io/react';
function Answer({ conversationId }) {
const { text, done, error } = useStream(`private-conversation-${conversationId}`, { rewind: true });
return <p aria-busy={!done}>{text}{error && <em> ({error})</em>}</p>;
}@hibira-io/vue มี useStream() แบบเดียวกัน และ Nuxt นำเข้าให้อัตโนมัติ ถ้าต้องการปุ่มหยุด ให้ส่ง signal จาก AbortController ไปที่ streamToChannel() แล้วสั่ง abort จาก route สำหรับหยุด
เอเจนต์ Laravel AI SDK
ใส่เอเจนต์ลงคิวแล้วบรอดแคสต์อีเวนต์ของมันไปที่แชนเนลส่วนตัวของผู้ใช้ ข้อความ การให้เหตุผล การเรียกเครื่องมือ และคำขออนุมัติจะมาถึงตามลำดับ และส่วนที่ใหญ่กว่าขนาดอีเวนต์ของแพ็กเกจจะถูกแบ่ง:
use Hibira\Laravel\Ai\AgentChannel;

(new SalesCoach)->broadcastOnQueue($request->input('prompt'), AgentChannel::user($request->user()));
const { text, status, toolCalls, approvals } = useAgentStream(`private-hibira-ai.user.${user.id}`, { rewind: true });status เป็น streaming, awaiting_approval, done หรือ error หน้าเว็บจึงแสดงได้ว่าเอเจนต์กำลังทำอะไร
ขั้นตอนของเอเจนต์และการอนุมัติ
หากต้องการแสดงแต่ละขั้นตอนการทำงานของเอเจนต์ ขอความเห็นจากคนก่อนเรียกเครื่องมือที่มีความเสี่ยง หรือให้เอเจนต์ใน MCP client รายงานความคืบหน้า ดูที่ เอเจนต์ AI: แสดงขั้นตอนสด การอนุมัติ และการแจ้งเตือน ทั้งสองใช้แชนเนลชุดเดียวกัน หน้าเดียวจึงแสดงทั้งคำตอบที่กำลังสตรีมและขั้นตอนของเอเจนต์ได้
แบบไม่ใช้แพ็กเกจ
จากไลบรารีเซิร์ฟเวอร์ Pusher ใดก็ได้ ส่งสิ่งที่โมเดลเขียนทุก 100 ms และใส่หมายเลขให้แต่ละชุด เบราว์เซอร์จะเรียงลำดับและรู้ได้เมื่อมีชุดหายไป:
seq, buffer, last = 0, "", time.monotonic()
for delta in model_stream:
    buffer += delta
    if time.monotonic() - last >= 0.1 or len(buffer) >= 1000:
        pusher_client.trigger(f"private-chat-{chat_id}", "ai-delta", {"id": answer_id, "seq": seq, "text": buffer})
        seq, buffer, last = seq + 1, "", time.monotonic()
pusher_client.trigger(f"private-chat-{chat_id}", "ai-done", {"id": answer_id, "seq": seq, "text": buffer})
บันทึกคำตอบที่เสร็จแล้วในฐานข้อมูลของคุณ และโหลดหนึ่งครั้งเมื่อเปิดหน้าหรือเชื่อมต่อใหม่ รูปแบบเดียวกันกับ queue worker ดูได้ที่ความคืบหน้าของงานที่ใช้เวลานาน
เคล็ดลับ
- การเผยแพร่แต่ละครั้งนับเป็นหนึ่งข้อความ ไม่ว่าจะมีกี่หน้าจอที่ได้รับ ที่ 50 token ต่อวินาที คำตอบ 20 วินาทีจะเป็นประมาณ 1,000 ข้อความถ้าส่งทีละ token และประมาณ 200 ข้อความถ้าส่งเป็นชุดทุก 100 ms
- ให้แต่ละอีเวนต์เล็กกว่าขนาดอีเวนต์ของแพ็กเกจ (Free คือ 4 KB ดูราคา) แพ็กเกจจะคุมไว้ไม่เกิน 3,500 ไบต์และแบ่งส่วนที่ใหญ่กว่า
- ประวัติของแชนเนลมีในแพ็กเกจ Hobby ขึ้นไป ถ้าไม่เปิด แพ็กเกจก็ยังสตรีมได้ และหน้าจอที่พลาดคำตอบบางส่วนจะแสดงว่าไม่สมบูรณ์แทนการแสดงเนื้อหาที่เสีย
- ถ้ามีแท็บเดียวที่ไม่ถูกรีโหลด การสตรีมผ่าน HTTP ธรรมดาก็เพียงพอ ใช้แชนเนลเมื่อคำตอบต้องอยู่รอดหลังรีโหลด ต้องไปถึงหลายอุปกรณ์หรือหลายคน หรือมาจากงานเบื้องหลัง
- ถ้าผู้ใช้ปิดแอปก่อนคำตอบยาว ๆ หรืองานของเอเจนต์จะเสร็จ ให้ส่งการแจ้งเตือนแบบพุชด้วยคู่มือการแจ้งเตือนแบบพุช