
把 AI 回答串流到每個畫面
聊天機器人、copilot 與 AI 代理:邊寫邊出現的回答,送到每個分頁與裝置,重新整理後接著寫。
聊天機器人、copilot 與 AI 代理要讓人覺得快,靠的是模型一邊寫、畫面一邊出現答案。多數應用是用發問的那一個 HTTP 回應來串流。這在使用者重新整理頁面、開第二個分頁、換到手機,或同事也想看同一個回答時就不夠用了。很長的回答也可能超過 serverless 函式的執行時間上限。把回答發布到頻道,就能把模型的工作和瀏覽器的連線分開:每個訂閱中的畫面看到同一段文字,斷線的畫面回來時從頻道歷史補上。常見的技術棧都有我們的開源套件處理分批、排序和補資料,你只要加幾行,不用自己寫。
使用者得到什麼
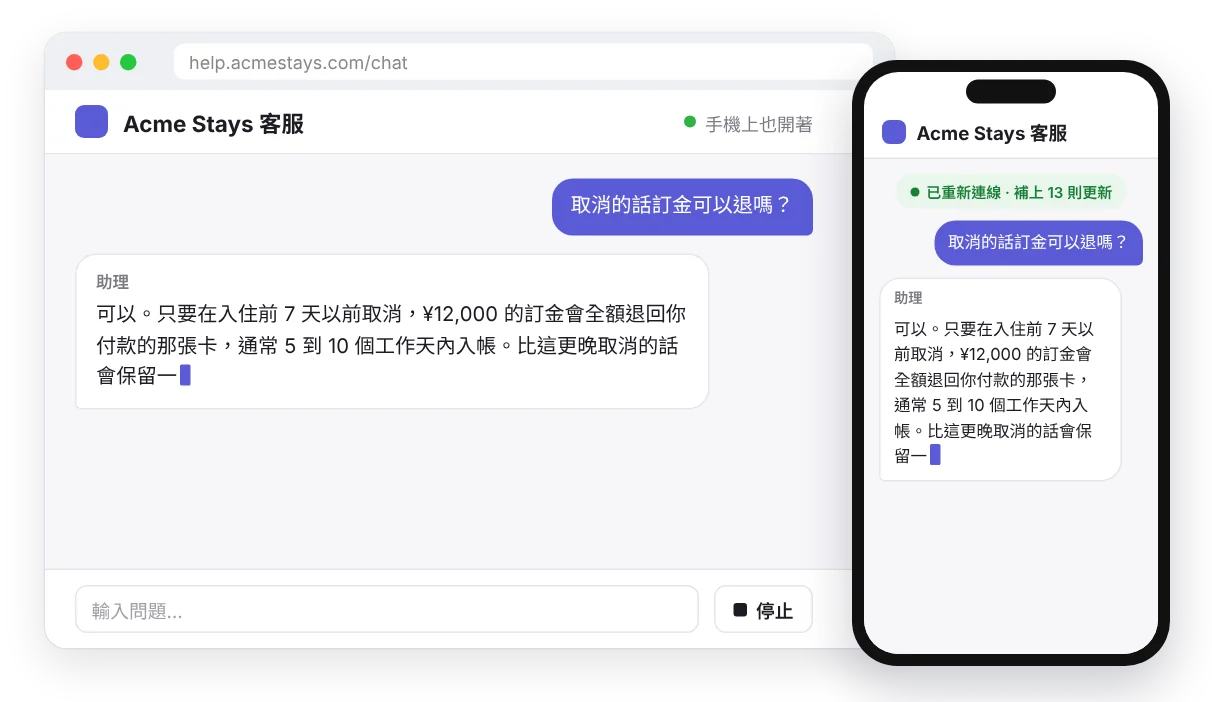
- 答案一個字一個字出現,不用等整段回答寫完。
- 每個分頁、每台裝置,以及共用聊天裡的每個人,都看到同一個回答。
- 重新整理或斷線後,回答繼續寫下去,只補上漏掉的文字,不會從頭再來。
- 「停止」按鈕;使用者關掉分頁後回答也會繼續寫,回來時結果已經好了。
使用的功能
- 私人頻道,只有能進入這段對話的人才讀得到回答,由你的授權端點檢查。
- 頻道歷史(
pusher:rewind,Hobby 以上方案,在各 app 的設定中開啟),重新連線的畫面會收到它漏掉的事件。 - 我們的套件,支援 Vercel AI SDK、React、Vue、Nuxt 與 Laravel。它們把 token 打包成小於 Free 4 KB 上限的事件、編號,再依序組回來。
- 你自己的模型與 API 金鑰:任何能串流文字的模型都可以。Hibira 只負責把文字送到使用者面前。
依技術棧選套件
| 你用的是 | 套件 | 瀏覽器端 |
|---|---|---|
Vercel AI SDK useChat | @hibira-io/ai-sdk | HibiraChatTransport |
| Anthropic、OpenAI 或 Gemini SDK,搭配 React 或 Vue | @hibira-io/react、@hibira-io/vue | useStream() |
| Laravel AI SDK 代理 | hibira-io/laravel | useAgentStream() |
| 其他語言或框架 | 任何 Pusher 伺服器函式庫 | pusher-js |
Vercel AI SDK:給 useChat 的 transport
useChat() 照原本的用法,只是回答改從頻道送來,而不是 HTTP 回應。瀏覽器端:
import { useChat } from '@ai-sdk/react';
import { HibiraChatTransport } from '@hibira-io/ai-sdk';

const transport = new HibiraChatTransport({ pusher, api: '/api/chat' });

export function Chat({ id, initialMessages }) {
  const { messages, sendMessage, status } = useChat({ id, messages: initialMessages, transport, resume: true });
  // render messages as usual
}
API route 立刻回應,並在背景發布模型的串流:
import { after } from 'next/server';
import { streamText, convertToModelMessages } from 'ai';
import { publishUIMessageStream } from '@hibira-io/ai-sdk/server';

export async function POST(req: Request) {
  const { id, messages, runId } = await req.json();
  const result = streamText({ model, messages: await convertToModelMessages(messages) });
  after(() =>
    publishUIMessageStream(pusher, {
      chatId: id,
      runId,
      stream: result.toUIMessageStream({ originalMessages: messages, onFinish: ({ messages }) => saveChat(id, messages) }),
    }),
  );
  return Response.json({ runId }, { status: 202 });
}
transport 會訂閱 private-ai-chat-{chatId},所以在授權端點裡只允許聊天的擁有者訂閱。加上 resume: true,重新整理的頁面會接著顯示還在寫的回答。
React 或 Vue,搭配任何模型 SDK
streamToChannel() 直接吃 Anthropic、OpenAI 或 Gemini SDK 回傳的串流:
import { streamToChannel } from '@hibira-io/react/server';

export async function POST(req) {
  const { conversationId, question } = await req.json();
  const stream = anthropic.messages.stream({ model, max_tokens: 1024, messages: [{ role: 'user', content: question }] });
  const id = crypto.randomUUID();
  streamToChannel(pusher, `private-conversation-${conversationId}`, stream, { id }).catch(console.error);
  return Response.json({ id });
}
import { useStream } from '@hibira-io/react';
function Answer({ conversationId }) {
const { text, done, error } = useStream(`private-conversation-${conversationId}`, { rewind: true });
return <p aria-busy={!done}>{text}{error && <em> ({error})</em>}</p>;
}@hibira-io/vue 也有同樣的 useStream(),Nuxt 會自動幫你匯入。要加「停止」按鈕,就把 AbortController 的 signal 傳給 streamToChannel(),在你的停止 route 裡呼叫 abort。
Laravel AI SDK 代理
把代理排入佇列,並把它的事件廣播到使用者的私人頻道;文字、推理、工具呼叫與核准請求都會依序送達,超過方案事件大小的會自動拆開:
use Hibira\Laravel\Ai\AgentChannel;

(new SalesCoach)->broadcastOnQueue($request->input('prompt'), AgentChannel::user($request->user()));
const { text, status, toolCalls, approvals } = useAgentStream(`private-hibira-ai.user.${user.id}`, { rewind: true });status 會是 streaming、awaiting_approval、done 或 error,頁面可以據此顯示代理正在做什麼。
代理步驟與核准
要顯示代理的每個步驟、在執行有風險的工具前先問人,或讓 MCP 用戶端裡的代理回報進度,請看 AI 代理:即時步驟、人工核准與通知。兩者用的是同一套頻道,所以同一個頁面可以同時顯示串流中的回答和代理的步驟。
不用套件的寫法
用任何 Pusher 伺服器函式庫,每 100 ms 送出模型寫好的內容並替每批編號,瀏覽器就能依序組回、發現缺漏:
seq, buffer, last = 0, "", time.monotonic()
for delta in model_stream:
    buffer += delta
    if time.monotonic() - last >= 0.1 or len(buffer) >= 1000:
        pusher_client.trigger(f"private-chat-{chat_id}", "ai-delta", {"id": answer_id, "seq": seq, "text": buffer})
        seq, buffer, last = seq + 1, "", time.monotonic()
pusher_client.trigger(f"private-chat-{chat_id}", "ai-done", {"id": answer_id, "seq": seq, "text": buffer})
把完成的回答存進你的資料庫,頁面開啟或重新連線時讀一次。搭配佇列 worker 的同樣做法,請看長時間工作的進度。
小技巧
- 每次發布算一則訊息,不論有多少畫面收到。以每秒 50 個 token 計算,20 秒的回答逐 token 送出約 1,000 則,每 100 ms 一批約 200 則。
- 每個事件要小於你方案的事件大小上限(Free 為 4 KB,見方案與價格)。套件會控制在 3,500 bytes 以內,更大的會自動拆開。
- 頻道歷史需要 Hobby 以上方案。沒開的話套件一樣能串流,漏掉一段的畫面會標示為不完整,而不是顯示壞掉的內容。
- 只有一個分頁、也不會重新整理的情況,用一般的 HTTP 串流就夠了。回答需要撐過重新整理、送到多台裝置或多個人,或是來自背景工作時,再用頻道。
- 如果使用者在長回答或代理工作完成前就關掉 app,用推播通知指南送一則推播。