
Truyền câu trả lời AI tới mọi màn hình
Chatbot, copilot và AI agent: câu trả lời hiện ra khi đang viết, tới mọi tab và thiết bị, và tiếp tục sau khi tải lại.
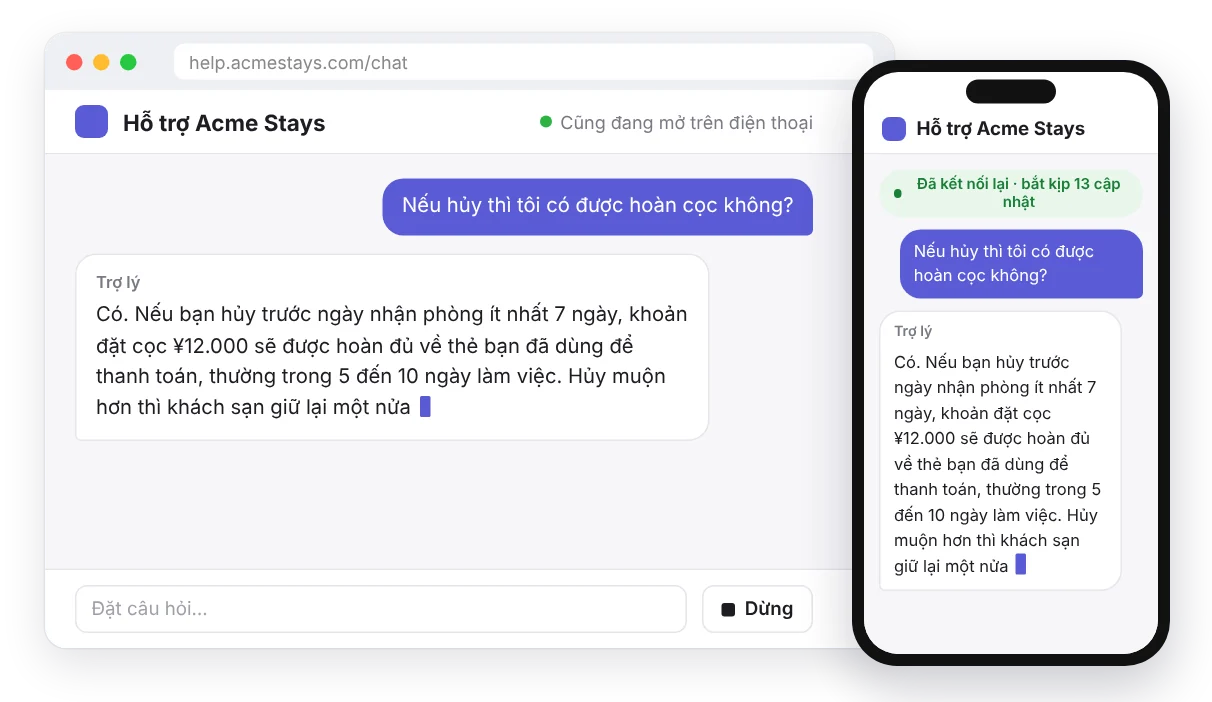
Chatbot, copilot và AI agent có cảm giác nhanh khi câu trả lời hiện ra ngay trong lúc mô hình đang viết. Phần lớn ứng dụng truyền câu trả lời qua chính HTTP response đã gửi câu hỏi. Cách này ổn cho đến khi người dùng tải lại trang, mở tab thứ hai, chuyển sang điện thoại, hoặc đồng nghiệp muốn xem cùng câu trả lời. Câu trả lời dài cũng có thể vượt giới hạn thời gian chạy của hàm serverless. Phát câu trả lời lên một kênh giúp tách công việc của mô hình khỏi kết nối của trình duyệt: mọi màn hình đang đăng ký đều thấy cùng một đoạn văn bản, và màn hình bị rớt kết nối sẽ bắt kịp từ lịch sử kênh. Các stack phổ biến đều có gói mã nguồn mở của chúng tôi lo việc gom lô, sắp thứ tự và bắt kịp, nên bạn chỉ thêm vài dòng thay vì tự viết.
Người dùng của bạn nhận được gì
- Câu trả lời hiện ra từng chữ, không phải chờ cả đoạn.
- Cùng một câu trả lời trên mọi tab, mọi thiết bị và cho mọi người trong cuộc trò chuyện chung.
- Câu trả lời vẫn tiếp tục sau khi tải lại trang hoặc mất kết nối, chỉ bổ sung phần còn thiếu thay vì bắt đầu lại.
- Nút "Dừng", và câu trả lời vẫn được viết tiếp sau khi người dùng đóng tab, nên khi quay lại kết quả đã sẵn sàng.
Xây dựng bằng
- Kênh riêng tư, để chỉ những người được vào cuộc trò chuyện mới đọc được câu trả lời. Endpoint xác thực của bạn kiểm tra điều đó.
- Lịch sử kênh (
pusher:rewind, gói Hobby trở lên, bật cho từng ứng dụng trong phần cài đặt), để màn hình kết nối lại nhận được các sự kiện đã lỡ. - Các gói của chúng tôi cho Vercel AI SDK, React, Vue, Nuxt và Laravel. Chúng gom token thành các sự kiện nhỏ hơn giới hạn 4 KB của Free, đánh số và ghép lại đúng thứ tự.
- Mô hình và API key của riêng bạn: mô hình nào truyền văn bản theo luồng đều dùng được. Hibira chỉ đưa văn bản tới người dùng của bạn.
Chọn gói theo stack của bạn
| Bạn dùng | Gói | Phía trình duyệt |
|---|---|---|
Vercel AI SDK useChat | @hibira-io/ai-sdk | HibiraChatTransport |
| SDK của Anthropic, OpenAI hoặc Gemini, với React hoặc Vue | @hibira-io/react, @hibira-io/vue | useStream() |
| Agent của Laravel AI SDK | hibira-io/laravel | useAgentStream() |
| Ngôn ngữ hoặc framework khác | bất kỳ thư viện máy chủ Pusher nào | pusher-js |
Vercel AI SDK: transport cho useChat
useChat() vẫn dùng như cũ; câu trả lời chỉ đến qua kênh thay vì HTTP response. Trong trình duyệt:
import { useChat } from '@ai-sdk/react';
import { HibiraChatTransport } from '@hibira-io/ai-sdk';

const transport = new HibiraChatTransport({ pusher, api: '/api/chat' });

export function Chat({ id, initialMessages }) {
  const { messages, sendMessage, status } = useChat({ id, messages: initialMessages, transport, resume: true });
  // render messages as usual
}
API route trả lời ngay và phát luồng của mô hình ở nền:
import { after } from 'next/server';
import { streamText, convertToModelMessages } from 'ai';
import { publishUIMessageStream } from '@hibira-io/ai-sdk/server';

export async function POST(req: Request) {
  const { id, messages, runId } = await req.json();
  const result = streamText({ model, messages: await convertToModelMessages(messages) });
  after(() =>
    publishUIMessageStream(pusher, {
      chatId: id,
      runId,
      stream: result.toUIMessageStream({ originalMessages: messages, onFinish: ({ messages }) => saveChat(id, messages) }),
    }),
  );
  return Response.json({ runId }, { status: 202 });
}
Transport đăng ký private-ai-chat-{chatId}, vì vậy trong endpoint xác thực chỉ cho phép chủ cuộc trò chuyện vào kênh này. Với resume: true, trang được tải lại sẽ tiếp tục câu trả lời đang viết dở.
React hoặc Vue với bất kỳ SDK mô hình nào
streamToChannel() nhận nguyên luồng mà SDK của Anthropic, OpenAI hoặc Gemini trả về:
import { streamToChannel } from '@hibira-io/react/server';

export async function POST(req) {
  const { conversationId, question } = await req.json();
  const stream = anthropic.messages.stream({ model, max_tokens: 1024, messages: [{ role: 'user', content: question }] });
  const id = crypto.randomUUID();
  streamToChannel(pusher, `private-conversation-${conversationId}`, stream, { id }).catch(console.error);
  return Response.json({ id });
}
import { useStream } from '@hibira-io/react';
function Answer({ conversationId }) {
const { text, done, error } = useStream(`private-conversation-${conversationId}`, { rewind: true });
return <p aria-busy={!done}>{text}{error && <em> ({error})</em>}</p>;
}@hibira-io/vue có cùng useStream(), và Nuxt tự import cho bạn. Để thêm nút Dừng, truyền signal của một AbortController vào streamToChannel() rồi gọi abort từ route dừng của bạn.
Agent của Laravel AI SDK
Đưa agent vào hàng đợi và phát các sự kiện của nó lên kênh riêng tư của người dùng; văn bản, suy luận, lời gọi công cụ và yêu cầu phê duyệt đến đúng thứ tự, phần nào lớn hơn kích thước sự kiện của gói sẽ được chia nhỏ:
use Hibira\Laravel\Ai\AgentChannel;

(new SalesCoach)->broadcastOnQueue($request->input('prompt'), AgentChannel::user($request->user()));
const { text, status, toolCalls, approvals } = useAgentStream(`private-hibira-ai.user.${user.id}`, { rewind: true });status là streaming, awaiting_approval, done hoặc error, nên trang có thể hiển thị agent đang làm gì.
Các bước của agent và phê duyệt
Để hiển thị từng bước làm việc của agent, hỏi một người trước khi chạy công cụ rủi ro, hoặc để agent trong MCP client báo tiến độ, xem AI agent: từng bước trực tiếp, phê duyệt và thông báo. Hai trang dùng cùng các kênh, nên một trang có thể hiển thị cả câu trả lời đang truyền và các bước của agent.
Không dùng gói
Từ bất kỳ thư viện máy chủ Pusher nào, gửi những gì mô hình đã viết mỗi 100 ms và đánh số từng lô, để trình duyệt ghép đúng thứ tự và nhận ra lô bị thiếu:
seq, buffer, last = 0, "", time.monotonic()
for delta in model_stream:
    buffer += delta
    if time.monotonic() - last >= 0.1 or len(buffer) >= 1000:
        pusher_client.trigger(f"private-chat-{chat_id}", "ai-delta", {"id": answer_id, "seq": seq, "text": buffer})
        seq, buffer, last = seq + 1, "", time.monotonic()
pusher_client.trigger(f"private-chat-{chat_id}", "ai-done", {"id": answer_id, "seq": seq, "text": buffer})
Lưu câu trả lời hoàn chỉnh vào cơ sở dữ liệu của bạn và tải một lần khi trang mở hoặc kết nối lại. Xem tiến độ cho tác vụ dài để biết cùng cách làm với queue worker.
Mẹo
- Mỗi lần phát là một tin nhắn, dù có bao nhiêu màn hình nhận. Ở tốc độ 50 token mỗi giây, câu trả lời 20 giây gửi từng token là khoảng 1.000 tin nhắn, còn gửi theo lô 100 ms là khoảng 200.
- Giữ mỗi sự kiện nhỏ hơn kích thước sự kiện của gói (Free là 4 KB, xem bảng giá). Các gói giữ dưới 3.500 byte và chia nhỏ phần lớn hơn.
- Lịch sử kênh có từ gói Hobby trở lên. Không bật thì các gói vẫn truyền được, và màn hình lỡ một phần câu trả lời sẽ đánh dấu là chưa đầy đủ thay vì hiện nội dung hỏng.
- Chỉ một tab và không bao giờ tải lại thì truyền qua HTTP thông thường là đủ. Dùng kênh khi câu trả lời phải giữ được sau khi tải lại, tới nhiều thiết bị hoặc nhiều người, hay đến từ tác vụ nền.
- Nếu người dùng đóng ứng dụng trước khi câu trả lời dài hay tác vụ của agent hoàn tất, hãy gửi thông báo đẩy theo hướng dẫn thông báo đẩy.