
把实时功能写成 hooks:我们为 React、Vue 和 Nuxt 做的包
· Hibira
每个团队把 pusher-js 接进 React 或 Vue 时,都会写一样的 useEffect、踩一样的坑。我们把它整理成三个包,还让它们把 AI 的回答实时送到每一个标签页、每一位同事。
把 pusher-js 接进 React,大概是这样开始的:
useEffect(() => {
  const channel = pusher.subscribe('orders');
  channel.bind('order.created', (order) => setOrders((list) => [order, ...list]));
  return () => pusher.unsubscribe('orders');
}, []);
六行,看起来没什么问题。然后项目长大了:订单列表和右上角的通知铃铛都要听 orders;切换页面时铃铛还在,列表卸载了,铃铛就再也收不到通知。开发模式下 React 的 StrictMode 会把组件挂载两次,连接也跟着开了两条。换成 Next.js 之后,服务器渲染时 new Pusher() 也跑了一次,在服务器上连了一条没人用的 WebSocket。
这些坑我们在很多项目的代码里都看过,写法几乎一模一样,踩的坑也一模一样。所以我们把它们整理成三个包:@hibira-io/react、@hibira-io/vue 和 @hibira-io/nuxt。这篇文章说说它们解决了什么问题、怎么解决的,以及顺便做的另一件事:把 AI 的回答实时送到每一个标签页、每一位同事。
第一个坑:两个组件,一个频道
pusher-js 的 subscribe() 对同一个频道名称只会订阅一次,两个组件拿到的是同一个频道对象。问题在 unsubscribe():它不管还有谁在用,直接把频道整个退订。
我们的解法是帮每个频道记一个计数:每个用到它的组件加一,卸载时减一,归零时才真正退订。你只要写 useChannel('orders') 或 useEvent('orders', 'order.created', handler),谁先谁后、谁先卸载都不用管。
挂载
卸载
useEvent 也会记住你最新的处理函数。组件每次重新渲染都会产生新的函数,如果每次都重新绑定事件,忙碌的频道上会出现短暂的空窗;我们只绑一次,事件来的时候才调用最新的那一个。
第二个坑:服务器渲染和 StrictMode
Next.js、Remix、Nuxt 都会先在服务器上渲染一次页面。如果在组件的本体或 useMemo 里创建连接,服务器上也会跟着连接:多一条没人用的 WebSocket,还多算一条连接数。
React 18 之后的 StrictMode 会在开发模式下把组件挂载、卸载、再挂载一次,用来找出没有清干净的副作用。手写的连接代码常常在这里留下第二条连接。
HibiraProvider 只在 useEffect 里创建连接,卸载时中断,StrictMode 的第二次挂载会拿到一条干净的新连接。连接创建之前,usePresence 返回空的成员列表、useConnectionState 返回 initialized,和服务器渲染出来的结果一样,所以 hydration 不会出现不一致的警告。Vue 版本也是一样的做法:插件在浏览器里第一次被用到时才连接,服务器上什么都不做。
第三件事:AI 的回答,不只给发问的那个标签页
这两年很多产品都加上了 AI 助手。最常见的做法是用 Server-Sent Events:浏览器发一个请求,后端把模型生成的文本一段一段写回同一个响应。
这在一个人、一个标签页的时候很好用。但产品一旦变成多人协作,问题就来了:Alice 在共享的规格文档里问了 AI 一个问题,坐在旁边的 Bob 看不到答案正在生成,要等 Alice 那边写完、存盘、Bob 刷新之后才看得到。Alice 自己开了两个标签页,另一个标签页也看不到。手机网络断了一下,SSE 的响应就断了,答案只剩一半。
Server-Sent Events
送到频道
trigger()所以我们在包里加了一组工具:后端的 streamToChannel() 和前端的 useStream()。后端把模型的流式输出交给 streamToChannel(),它会把文本发布到一个频道;前端任何订阅了这个频道的组件,都用 useStream() 拿到逐渐长出来的文本。
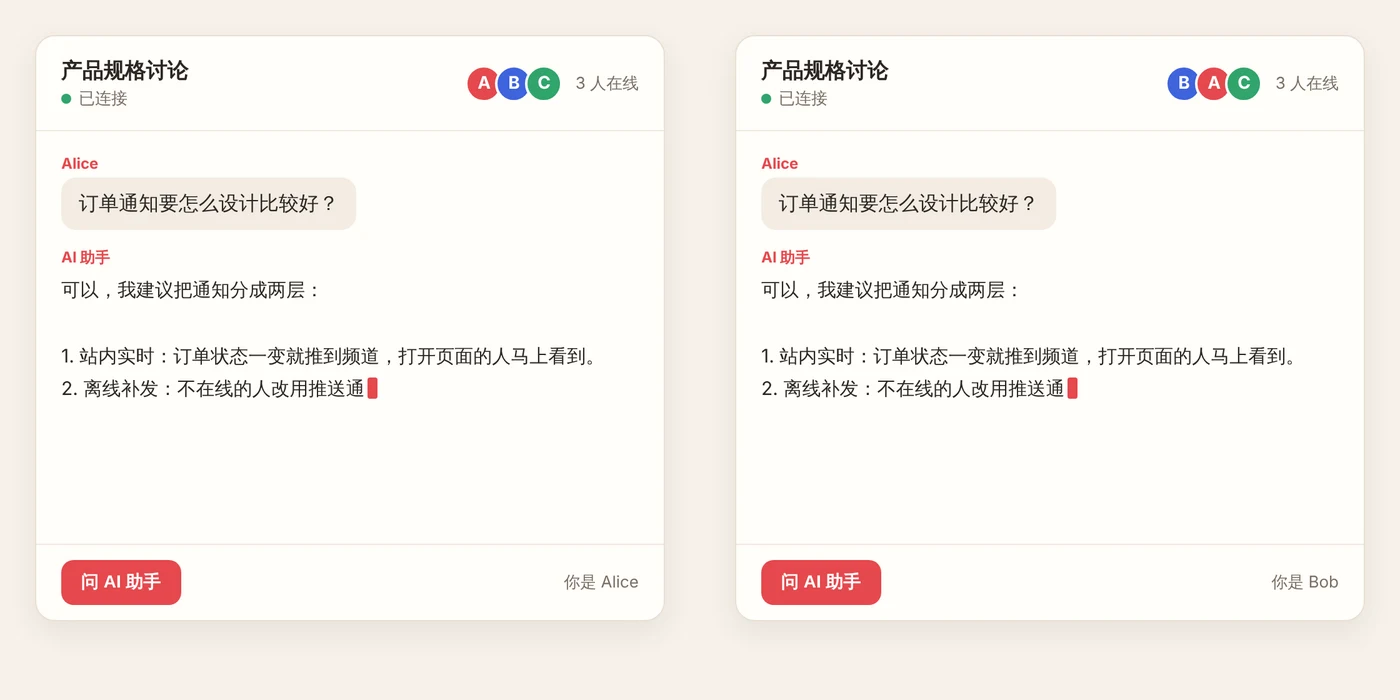
上图是我们在本机测试时截的:Alice 按下「问 AI 助手」,答案同时出现在 Alice 和 Bob 的屏幕上,Bob 不需要做任何操作。
不是每个 token 一条消息
模型生成文本的速度大约是每秒几十个 token。如果每个 token 都发布一条消息,一个长一点的回答就是上千条,消息额度很快就用完,接收端的浏览器也要处理上千次重新渲染。
streamToChannel() 会把 token 先收集起来,每 100 毫秒发布一次。不管模型多快,一个频道每秒大约只会收到十条消息,画面看起来仍然是连续流出来的。
模型越快,省得越多:同样 1,000 个 token,模型每秒生成 100 个时只要 103 条。每一条消息也会控制在 3,500 bytes 以内,低于免费方案每条 4 KB 的上限;切开长文本的时候不会把一个中文字或 emoji 切成两半。
顺序、断线和中途加入的人
每一条消息都带着一个序号,useStream() 依照序号把文本接起来,就算顺序乱了也会等缺的那一条到了再接。
最后一条消息除了「结束了」的标记,还会附上完整的回答(只要放得进一条消息)。这是为了中途才加入的人:Bob 在答案写到一半时才打开页面,他看不到前面的文本,但最后一条一到,他的画面就会换成完整的答案。网络断了一下的人也是一样。
如果回答太长,最后一条放不下完整的文本,中途加入的人会看到 incomplete: true,你可以在这时打一次 API 拿存好的完整回答。模型出错或被中断时,订阅的人也会收到 error,不会一直停在「生成中」。
实际写起来是这样
React
import { HibiraProvider, useEvent, usePresence, useStream } from '@hibira-io/react';

export function App() {
  return (
    <HibiraProvider appKey="你的 app key" options={{ channelAuthorization: { endpoint: '/api/hibira/auth', transport: 'ajax' } }}>
      <Room id="spec-42" />
    </HibiraProvider>
  );
}

function Room({ id }) {
  const { members } = usePresence(`presence-room-${id}`);
  const { text, done } = useStream(`private-room-${id}-ai`);
  useEvent(`private-room-${id}`, 'comment.created', (comment) => addComment(comment));
  return (
    <>
      <Avatars members={members} />
      <Answer text={text} loading={!done} />
    </>
  );
}
后端(Node.js,任何框架都可以)把模型的流式输出原封不动交给 streamToChannel()。Anthropic、OpenAI、Gemini 和 Vercel AI SDK 的流格式它都认得:
import Pusher from 'pusher';
import { streamToChannel } from '@hibira-io/react/server';

const pusher = new Pusher({ appId, key, secret, host: 'ws.hibira.io', useTLS: true });
const stream = anthropic.messages.stream({ model, max_tokens: 1024, messages });
await streamToChannel(pusher, `private-room-${id}-ai`, stream, { meta: { asker: user.name } });
Vue
Vue 3 和 Vue 2.7 都能用,频道名称可以是 ref 或 getter,路由参数变了,订阅会自动跟着换:
// main.js
createApp(App)
  .use(createHibira({ appKey: import.meta.env.VITE_HIBIRA_KEY, options: { channelAuthorization: { endpoint: '/api/hibira/auth', transport: 'ajax' } } }))
  .mount('#app');
<script setup>
import { usePresence, useStream } from '@hibira-io/vue';
const props = defineProps({ id: String });
const { members, count } = usePresence(() => `presence-room-${props.id}`);
const { text, done } = useStream(() => `private-room-${props.id}-ai`);
</script>Nuxt
Nuxt 3 和 Nuxt 4 只要加一行模块设置,composables 会自动导入,服务器路由里也直接有 useHibiraServer() 和 streamToChannel() 可以用:
// nuxt.config.ts
export default defineNuxtConfig({
  modules: ['@hibira-io/nuxt'],
});
// server/api/ask.post.ts
export default defineEventHandler(async (event) => {
const { roomId, question } = await readBody(event);
const stream = anthropic.messages.stream({ model, max_tokens: 1024, messages: [{ role: 'user', content: question }] });
event.waitUntil(streamToChannel(useHibiraServer(event), `private-room-${roomId}-ai`, stream));
return { ok: true };
});还在用 Nuxt 2 的项目也没有被忘记:Nuxt 2.16 之后跑在 Vue 2.7 上,改用 @hibira-io/nuxt/nuxt2 这个模块就可以。
我们怎么测试
这三个包都很小,没有额外的依赖,除了 pusher-js 之外什么都不用装。但它们会跑在很多种环境里,所以测试范围比代码本身大得多:
- React 17、18、19,Vue 3.5 和 Vue 2.7,各自跑一遍单元测试。
- 端到端测试:两个客户端连到真正的服务器,验证 presence 加入和离开、客户端事件,以及 200 个 token 的流式输出在两边都完整拼回来。
- Nuxt 4.6、3.21 和 2.18 各建一个小项目,在 Chromium 里打开两个用户,确认连接、presence、服务器事件和流式输出文本都正常,控制台没有错误、也没有 hydration 警告。
开始使用
npm install @hibira-io/react pusher-js   # React
npm install @hibira-io/vue pusher-js     # Vue 3 / Vue 2.7
npx nuxi module add @hibira-io/nuxt      # Nuxt 3 / 4
开始之前,有几件事要先在 Hibira 控制台设置好:
- 创建应用,记下凭证。 App ID 和 key 在应用的「概览」页面随时都能看到;secret 只会在创建时显示一次,请当下就存进后端的环境变量(Nuxt 用
NUXT_PUBLIC_HIBIRA_KEY、NUXT_HIBIRA_APP_ID、NUXT_HIBIRA_SECRET)。key 是公开的,secret 只能放在服务器上。 - 加上允许的来源。 免费方案不能用
*,要把你的网站地址(开发时例如http://localhost:3000)加进「允许的来源」,否则浏览器会连不上。 - 准备授权路由。 私有和 presence 频道需要后端的
/api/hibira/auth确认用户身份并签署订阅,三个 README 里都有可以直接复制的示例。 - 每条消息 4 KB。 免费方案每个事件最多 4 KB;
streamToChannel()已经自动把消息控制在这个范围内,自己发布的事件也要注意大小。
想亲手重现上面 Alice 和 Bob 的画面,请用两个不同的浏览器,或一个普通窗口加一个无痕窗口,各自登录不同账号。同一个浏览器开两个标签页通常是同一个用户,presence 只会算一个人。
三个包都是 MIT 授权,源代码在 GitHub 上:hibira-io/react、hibira-io/vue、hibira-io/nuxt。它们说的是 Pusher 协议,所以连到任何兼容的服务器都可以用;已经在用 Laravel Echo 的项目,把 echo.connector.pusher 传进去,就能和 Echo 共用同一条连接。
免费方案不需要信用卡。如果你的产品正打算加上 AI 助手,或者已经有一堆手写的 useEffect 在处理实时消息,可以挑一个页面换成这几个 hooks 试试看,有任何想法都欢迎在 GitHub 上开 issue 告诉我们。