
AI の回答をすべての画面にストリーミング
チャットボット、コパイロット、AI エージェント:書くそばから表示され、すべてのタブと端末に届き、再読み込み後も続く回答。
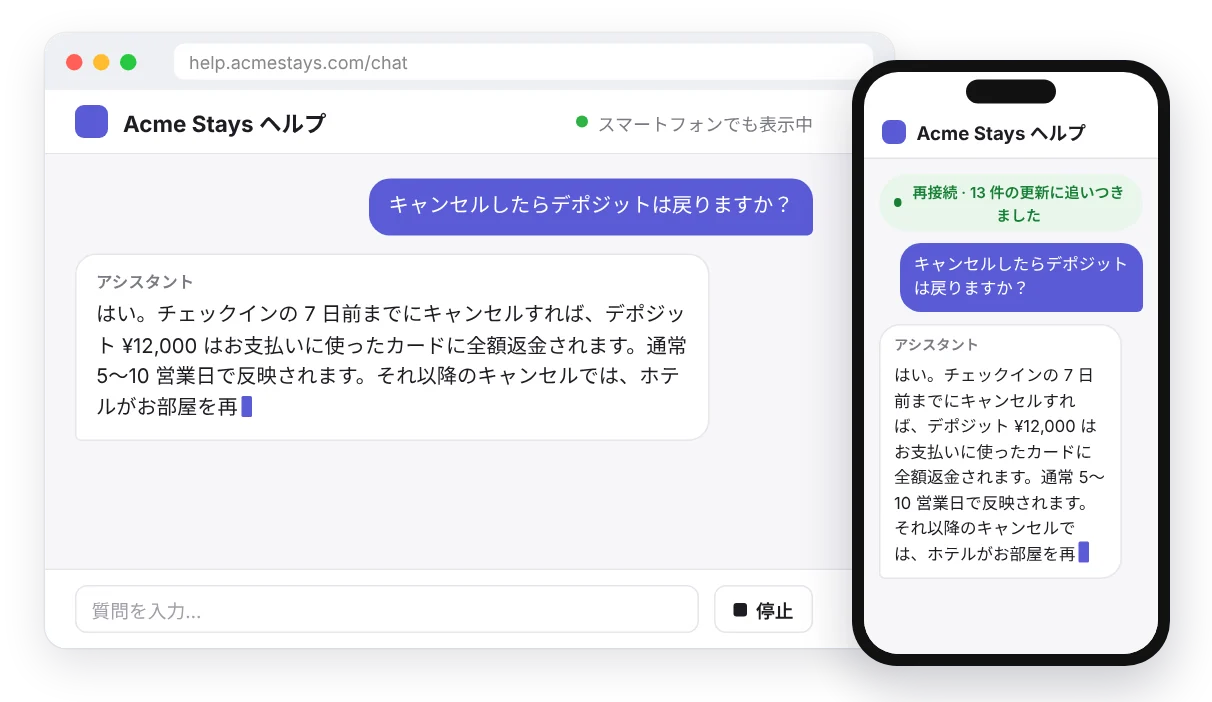
チャットボット、コパイロット、AI エージェントが速く感じられるのは、モデルが書くそばから答えが表示されるときです。多くのアプリは、質問を送った 1 本の HTTP レスポンスでストリーミングしています。これは、ユーザーがページを再読み込みしたとき、2 つ目のタブを開いたとき、スマートフォンに切り替えたとき、同僚が同じ回答を見たいときに足りなくなります。長い回答はサーバーレス関数の実行時間の上限を超えることもあります。回答をチャンネルに配信すれば、モデルの処理とブラウザの接続を切り離せます。購読しているすべての画面が同じテキストを表示し、切断した画面はチャンネル履歴から追いつきます。よく使われる技術スタックには、バッチ化・並べ替え・追いつきを担うオープンソースのパッケージがあるので、自分で書かずに数行を足すだけです。
ユーザーにとっての価値
- 回答全体を待たずに、言葉が順に表示されます。
- すべてのタブ、すべての端末、共有チャットの全員に同じ回答が届きます。
- 再読み込みや接続断のあとも回答は続き、最初からやり直さずに足りない部分だけを補います。
- 「停止」ボタン。タブを閉じても回答は書き続けられ、戻ったときには結果ができています。
使う機能
- プライベートチャンネル:会話に参加できる人だけが回答を読めます。確認はあなたの認可エンドポイントで行います。
- チャンネル履歴(
pusher:rewind、Hobby 以上のプラン、アプリごとに設定で有効化):再接続した画面は見逃したイベントを受け取ります。 - 私たちのパッケージ:Vercel AI SDK、React、Vue、Nuxt、Laravel に対応。トークンを Free の 4 KB 上限より小さいイベントにまとめ、番号を付け、順番どおりに組み立て直します。
- あなた自身のモデルと API キー:テキストをストリーミングできるモデルなら何でも使えます。Hibira はテキストをユーザーに届けるだけです。
技術スタックに合うパッケージを選ぶ
| 使っているもの | パッケージ | ブラウザ側 |
|---|---|---|
Vercel AI SDK useChat | @hibira-io/ai-sdk | HibiraChatTransport |
| Anthropic、OpenAI、Gemini の SDK と React または Vue | @hibira-io/react、@hibira-io/vue | useStream() |
| Laravel AI SDK のエージェント | hibira-io/laravel | useAgentStream() |
| その他の言語やフレームワーク | 任意の Pusher サーバーライブラリ | pusher-js |
Vercel AI SDK:useChat 用のトランスポート
useChat() はそのまま使えます。回答が HTTP レスポンスではなくチャンネルから届くようになるだけです。ブラウザ側:
import { useChat } from '@ai-sdk/react';
import { HibiraChatTransport } from '@hibira-io/ai-sdk';

const transport = new HibiraChatTransport({ pusher, api: '/api/chat' });

export function Chat({ id, initialMessages }) {
  const { messages, sendMessage, status } = useChat({ id, messages: initialMessages, transport, resume: true });
  // render messages as usual
}
API ルートはすぐに応答し、モデルのストリームをバックグラウンドで配信します:
import { after } from 'next/server';
import { streamText, convertToModelMessages } from 'ai';
import { publishUIMessageStream } from '@hibira-io/ai-sdk/server';

export async function POST(req: Request) {
  const { id, messages, runId } = await req.json();
  const result = streamText({ model, messages: await convertToModelMessages(messages) });
  after(() =>
    publishUIMessageStream(pusher, {
      chatId: id,
      runId,
      stream: result.toUIMessageStream({ originalMessages: messages, onFinish: ({ messages }) => saveChat(id, messages) }),
    }),
  );
  return Response.json({ runId }, { status: 202 });
}
トランスポートは private-ai-chat-{chatId} を購読するので、認可エンドポイントではチャットの所有者だけに許可してください。resume: true を付けると、再読み込みしたページはまだ書かれている途中の回答を引き継ぎます。
React または Vue と任意のモデル SDK
streamToChannel() は Anthropic、OpenAI、Gemini の SDK が返すストリームをそのまま受け取ります:
import { streamToChannel } from '@hibira-io/react/server';

export async function POST(req) {
  const { conversationId, question } = await req.json();
  const stream = anthropic.messages.stream({ model, max_tokens: 1024, messages: [{ role: 'user', content: question }] });
  const id = crypto.randomUUID();
  streamToChannel(pusher, `private-conversation-${conversationId}`, stream, { id }).catch(console.error);
  return Response.json({ id });
}
import { useStream } from '@hibira-io/react';
function Answer({ conversationId }) {
const { text, done, error } = useStream(`private-conversation-${conversationId}`, { rewind: true });
return <p aria-busy={!done}>{text}{error && <em> ({error})</em>}</p>;
}@hibira-io/vue にも同じ useStream() があり、Nuxt では自動でインポートされます。停止ボタンを付けるには、AbortController の signal を streamToChannel() に渡し、停止用のルートで abort します。
Laravel AI SDK のエージェント
エージェントをキューに入れ、そのイベントをユーザーのプライベートチャンネルにブロードキャストします。テキスト、推論、ツール呼び出し、承認リクエストが順番どおりに届き、プランのイベントサイズを超えるものは分割されます:
use Hibira\Laravel\Ai\AgentChannel;

(new SalesCoach)->broadcastOnQueue($request->input('prompt'), AgentChannel::user($request->user()));
const { text, status, toolCalls, approvals } = useAgentStream(`private-hibira-ai.user.${user.id}`, { rewind: true });status は streaming、awaiting_approval、done、error のいずれかなので、エージェントが何をしているかをページに表示できます。
エージェントのステップと承認
エージェントの各ステップの表示、リスクのあるツールを実行する前の確認、MCP クライアント内のエージェントからの進捗報告については、AI エージェント:進行状況のライブ表示、承認、通知を参照してください。同じチャンネルを使うので、ストリーミング中の回答とエージェントのステップを 1 つのページに並べられます。
パッケージを使わない場合
任意の Pusher サーバーライブラリから、モデルが書いた分を 100 ms ごとに送り、各バッチに番号を付けます。ブラウザは順番どおりに並べ、欠けたバッチに気づけます:
seq, buffer, last = 0, "", time.monotonic()
for delta in model_stream:
    buffer += delta
    if time.monotonic() - last >= 0.1 or len(buffer) >= 1000:
        pusher_client.trigger(f"private-chat-{chat_id}", "ai-delta", {"id": answer_id, "seq": seq, "text": buffer})
        seq, buffer, last = seq + 1, "", time.monotonic()
pusher_client.trigger(f"private-chat-{chat_id}", "ai-done", {"id": answer_id, "seq": seq, "text": buffer})
完成した回答はデータベースに保存し、ページを開いたときや再接続したときに 1 回読み込みます。キューワーカーでの同じパターンは時間のかかる処理の進捗を参照してください。
ヒント
- 何台の画面が受け取っても、1 回の配信は 1 メッセージです。毎秒 50 トークンの場合、20 秒の回答はトークンごとに送ると約 1,000 メッセージ、100 ms ごとのバッチなら約 200 メッセージです。
- 各イベントはプランのイベントサイズ上限より小さくします(Free は 4 KB、料金を参照)。パッケージは 3,500 バイト以内に収め、それより大きいものは分割します。
- チャンネル履歴は Hobby 以上のプランで使えます。無効でもパッケージはストリーミングでき、回答の一部を見逃した画面ではその回答が壊れた表示ではなく「不完全」として示されます。
- 再読み込みしない 1 つのタブだけなら、通常の HTTP ストリーミングで十分です。回答が再読み込みに耐える必要があるとき、複数の端末や複数の人に届けるとき、バックグラウンドジョブから送るときにチャンネルを使います。
- 長い回答やエージェントの作業が終わる前にユーザーがアプリを閉じた場合は、プッシュ通知ガイドでプッシュ通知を送ります。